- 1. Quels sont les LLM actuels ?
- 2. Comment fonctionnent les LLM ?
- 3. Avantages des masters en droit
- 4. Les défis du LLM
- 5. Cas d'utilisation et options de déploiement du LLM
- 6. LLM Préoccupations en matière de sécurité
- 7. Le Top 10 de l'OWASP : Risques liés à la sécurité du LLM
- 8. FAQ sur les grands modèles linguistiques
Sommaire
Que sont les large language models (LLM) ?
Sommaire
Les large language models (LLM) sont un développement de pointe en matière de traitement du langage naturel (NLP) conçu pour comprendre et générer du langage humain. Les LLM sont des modèles d'IA avancés formés sur de grandes quantités de données textuelles, ce qui leur permet de reconnaître des modèles linguistiques, de comprendre le contexte et de produire des réponses cohérentes et adaptées au contexte. Alors que le NLP fournit les techniques fondamentales permettant aux machines d'appréhender le langage, les LLM représentent une approche spécialisée qui a considérablement amélioré la capacité de la machine à imiter la compréhension et la génération du langage à l'instar de l'homme.
Quels sont les LLM actuels ?
Les LLM représentent la frontière du traitement du langage naturel, et plusieurs modèles dominent actuellement l'espace, notamment Gemini de Google, Galactica et Llama de Meta, la série GPT d'OpenAI, et d'autres comme Falcon 40B et Phi-1. Avec des architectures et des paramètres variés, ces modèles excellent dans des tâches allant de la réponse à des requêtes à la génération de textes cohérents et pertinents sur le plan contextuel dans de longs passages.
BERT, présenté par Google, a jeté les bases avec son architecture basée sur les transformateurs. D'autre part, Meta's Galactica, un nouveau venu, cible explicitement la communauté scientifique et fait l'objet d'un examen minutieux pour avoir produit des "hallucinations" trompeuses qui pourraient avoir de profondes implications dans le domaine scientifique. Entre-temps, la série GPT d'OpenAI, en particulier GPT-3 et GPT-4, a été révolutionnaire dans sa capacité, cette dernière contenant, selon les rumeurs, plus de 170 trillions de paramètres et pouvant traiter à la fois du texte et des images. Les prouesses de ce modèle ont donné lieu à des spéculations sur l'approche de l'intelligence générale artificielle (AGI), une capacité théorique de la machine égale ou supérieure à l'intelligence humaine.
Toutefois, les défis persistent. L'échelle et la complexité de ces modèles peuvent conduire à des résultats imprévisibles, et leurs exigences immenses en matière de formation soulèvent des inquiétudes quant à la durabilité environnementale et aux résultats biaisés.
Malgré ces inquiétudes, l'évolution des masters en droit promet des avancées dans divers secteurs, qu'il s'agisse de tâches banales comme l'amélioration des recherches sur le web ou de domaines essentiels comme la recherche médicale et la cybersécurité. À mesure que le domaine progresse, l'équilibre entre le potentiel et la prudence reste primordial.
Comment fonctionnent les LLM ?
Pour exceller dans la compréhension et la génération d'un langage semblable à celui des humains, les LLM utilisent une combinaison de réseaux neuronaux, de vastes ensembles de données d'entraînement et une architecture appelée transformateurs.
Réseaux neuronaux
Au cœur des grands modèles de langage se trouvent des réseaux neuronaux à plusieurs couches, connus sous le nom de modèles de Deep Learning. Ces réseaux sont constitués de nœuds interconnectés, ou neurones, qui apprennent à reconnaître des modèles dans les données d'entrée au cours de la phase d'apprentissage. Les LLM sont formés sur un corpus massif de textes, englobant diverses sources telles que des sites web, des livres et des articles, ce qui leur permet d'apprendre la grammaire, la syntaxe, la sémantique et les informations contextuelles.
Sur le dos d'algorithmes conçus pour reconnaître des modèles, les réseaux neuronaux interprètent les données sensorielles par une sorte de perception machine, d'étiquetage ou de regroupement des entrées brutes. Les architectures des réseaux neuronaux vont des simples réseaux de type feedforward, où les connexions entre les nœuds ne forment pas de cycle, aux structures complexes avec des couches sophistiquées et de multiples boucles de rétroaction.
Réseaux neuronaux conversationnels (CNN): Ils sont particulièrement efficaces pour le traitement des données ayant une topologie en grille. Parmi les exemples, on peut citer les données d'image, qui peuvent être considérées comme une grille de pixels en 2D.
Réseaux neuronaux récurrents (RNN): Ils sont adaptés aux données séquentielles telles que le texte et la parole. Le résultat de chaque étape dépend des calculs précédents et d'une certaine forme de mémoire sur ce qui a été traité jusqu'à présent.
Transformateurs
L'architecture du transformateur est un composant essentiel des LLM, introduit par Vaswani et al. en 2017. Les transformateurs répondent aux limites des modèles de séquence antérieurs, tels que les RNN et les LSTM, qui avaient du mal à gérer les dépendances à longue distance et la parallélisation. Les transformateurs utilisent un mécanisme appelé auto-attention, qui permet au modèle d'évaluer l'importance des différents mots dans le contexte d'entrée et de saisir les relations entre eux, quelle que soit leur distance dans la séquence.
Tokenisation
La tokenisation est la première étape du traitement d'un texte avec un LLM. Le texte d'entrée est décomposé en unités plus petites appelées tokens, qui sont ensuite converties en représentations numériques (vecteurs) que le réseau neuronal peut traiter. Au cours de l'apprentissage, le modèle apprend à générer des jetons de sortie appropriés au contexte en fonction des jetons d'entrée et de leurs relations.
Le processus de formation consiste à ajuster les poids des connexions du réseau neuronal par le biais d'une technique appelée rétropropagation. En minimisant la différence entre les prédictions du modèle et les mots cibles réels dans les données d'apprentissage, le modèle apprend à générer un langage plus précis et plus cohérent.
Une fois formés, les grands modèles de langage peuvent être affinés pour des tâches ou des domaines spécifiques, tels que l'analyse des sentiments, le résumé ou la réponse aux questions, en formant le modèle pendant une courte période sur un ensemble de données plus petit et spécifique à la tâche. Ce processus permet au LLM d'adapter sa compréhension généralisée de la langue aux nuances et aux exigences de la tâche cible.
Article connexe: L'intelligence artificielle expliquée
Avantages des masters en droit
Les grands modèles linguistiques offrent un large éventail d'avantages, notamment
- Compréhension avancée du langage naturel : Les LLM peuvent comprendre le contexte et les nuances de la langue, ce qui rend leurs réponses plus pertinentes et plus humaines.
- Polyvalence : Les LLM peuvent être appliqués à diverses tâches, telles que la génération de textes, le résumé, la traduction et la réponse à des questions, sans nécessiter de formation spécifique à la tâche.
- Traduction : Les linguistes formés à plusieurs langues peuvent traduire efficacement d'une langue à l'autre. Selon certaines théories, ils pourraient même déduire des significations de langues inconnues ou perdues en se basant sur des modèles.
- Automatiser les tâches banales : Les LLM peuvent effectuer des tâches liées au texte telles que le résumé, la reformulation et la création de contenu, ce qui peut être particulièrement utile pour les entreprises et les créateurs de contenu.
- Capacités émergentes : En raison de la grande quantité de données sur lesquelles ils sont formés, les LLM peuvent présenter des capacités inattendues mais impressionnantes, telles que l'arithmétique à plusieurs étapes, la réponse à des questions complexes et la génération de messages-guides en chaîne de pensée.
- Débogage et codage : Dans le domaine de la cybersécurité, les LLM peuvent contribuer à l'écriture et au débogage du code plus rapidement qu'avec les méthodes traditionnelles.
- Analyse des schémas de menaces : Dans le domaine de la cybersécurité, les LLM peuvent identifier des modèles liés aux menaces persistantes avancées, ce qui facilite l'attribution des incidents et l'atténuation en temps réel.
- Automatisation des réponses : Dans les centres d'opérations de sécurité, les LLM peuvent automatiser les réponses, générer des scripts et des outils, et aider à la rédaction de rapports, réduisant ainsi le temps que les professionnels de la sécurité consacrent aux tâches de routine.
Malgré ces avantages, il est essentiel de se rappeler que les masters en droit présentent des inconvénients et des considérations éthiques qu'il convient de gérer.
Les défis du LLM
S'il est facile de se laisser séduire par les avantages offerts par les impressionnantes capacités linguistiques d'un LLM, les organisations doivent également être conscientes des défis potentiels qui en découlent et s'y préparer.
Défis opérationnels
- Hallucination : Les LLM peuvent parfois produire des résultats bizarres et erronés ou donner l'impression d'être sensibles. Ces sorties ne sont pas basées sur les données d'entraînement du modèle et sont appelées "hallucinations".
- Parti pris : Si un LLM est formé sur des données biaisées, ses résultats peuvent être discriminatoires ou biaisés à l'encontre de certains groupes, races ou classes. Même après la formation, les préjugés peuvent évoluer en fonction des interactions avec l'utilisateur. Tay, de Microsoft, est un exemple notoire de la manière dont les préjugés peuvent se manifester et s'intensifier.
- Jetons d'erreur ou exemples contradictoires : Il s'agit d'entrées spécifiques conçues pour que le modèle produise des résultats erronés ou trompeurs, entraînant de fait un "dysfonctionnement" du modèle.
- Manque d'explicabilité : Il peut être difficile de comprendre comment les LLM prennent certaines décisions ou génèrent des résultats spécifiques, ce qui complique leur dépannage ou leur perfectionnement.
- Dépendance excessive : Les LLM étant de plus en plus intégrés dans divers secteurs, il existe un risque de dépendance excessive, susceptible de mettre à l'écart l'expertise et l'intuition humaines.
Cas d'utilisation et options de déploiement du LLM
Les LLM offrent aux organisations un certain nombre de modèles de mise en œuvre optionnels, chacun s'appuyant sur un ensemble différent d'outils et d'implications de sécurité connexes.
Utilisation de LLM pré-entraînés
Les fournisseurs de cloud comme OpenAI et Anthropic proposent un accès par API à de puissants LLM qu'ils gèrent et sécurisent. Les organisations peuvent tirer parti de ces API pour incorporer des capacités LLM dans leurs applications sans avoir à gérer l'infrastructure sous-jacente.
Par ailleurs, les LLM à code source ouvert, tels que le LLaMa de Meta, peuvent être exécutés sur la propre infrastructure d'une organisation, ce qui offre davantage de contrôle et d'options de personnalisation. Du côté des inconvénients, les LLM open-source nécessitent d'importantes ressources de calcul et une expertise en IA pour être mis en œuvre et maintenus en toute sécurité.
Modèles de déploiement des LLMs
- SaaS basé sur une interface utilisateur: L'infrastructure est fournie et gérée par le développeur du LLM (par exemple, OpenAI) et approvisionnée via une API publique.
- CSP-managed: Le LLM est déployé sur une infrastructure fournie par des hyperscalers en nuage et peut fonctionner dans un cloud privé ou public, tel qu'Azure, OpenAI et Amazon Bedrock.
- Autonome: Le LLM est déployé sur la propre infrastructure de l'entreprise, ce qui n'est pertinent que pour les modèles open-source ou homegrown.
Les LLM pré-entraînés offrent diverses fonctionnalités - génération de contenu, chatbots, analyse des sentiments, traduction linguistique et assistants de codage. Une entreprise de commerce électronique pourrait utiliser un LLM pour générer des descriptions de produits, tandis qu'une entreprise de développement de logiciels pourrait tirer parti d'un assistant de codage alimenté par un LLM pour stimuler la productivité des programmeurs.
Implications en matière de sécurité associées aux LLM pré-entraînés
La disponibilité d'API cloud facilement accessibles et de modèles open-source a considérablement abaissé les obstacles à l'ajout de fonctionnalités avancées de langage d'IA aux applications. Les développeurs peuvent désormais intégrer les LLM dans leurs logiciels sans avoir besoin d'une expertise approfondie en matière d'IA et de ML. Bien que cela accélère l'innovation, cela augmente le risque de projets d'IA fantômes qui ne bénéficient pas d'une surveillance adéquate en matière de sécurité et de conformité. Les équipes de développement, quant à elles, peuvent expérimenter les LLM sans tenir compte de la confidentialité des données, de la gouvernance du modèleet des questions de contrôle de la production.
Ajustement et génération améliorée en fonction de la recherche (RAG)
Pour personnaliser les LLM pour des applications spécifiques, les organisations peuvent les affiner sur des ensembles de données plus petits liés à la tâche souhaitée ou mettre en œuvre le RAG, qui implique l'intégration des LLM avec des bases de connaissances pour la réponse aux questions et le résumé du contenu. .
Les cas d'utilisation de ces derniers incluent des assistants IA spécialisés ayant accès aux données internes (par exemple, pour le support client, les RH ou le service d'assistance informatique) et des apps de questions-réponses (par exemple, pour la documentation, les référentiels des codes ou les supports de formation). Par exemple, le chatbot du service client d'une entreprise de télécommunications pourrait être affiné à partir de la documentation sur les produits, des FAQ ou des interactions antérieures avec le service d'assistance, afin de mieux aider les clients à résoudre les problèmes techniques et à gérer leur compte.
Implications en matière de sécurité liées à la mise au point et au RAG
Le réglage fin et le RAG permettent aux organisations d'adapter les LLM à leur domaine et à leurs données spécifiques, ce qui permet d'obtenir des résultats plus ciblés et plus précis. Cependant, ce processus de personnalisation implique souvent d'exposer le modèle à des informations internes sensibles au cours de la formation. De solides pratiques de gouvernance des données sont exigées pour garantir que seules les données autorisées sont utilisées pour le réglage fin et que les modèles qui en résultent sont sécurisés.
Modèle de formation
Certaines grandes entreprises technologiques et certains instituts de recherche choisissent d'investir dans la formation de leurs propres doctorants en droit. Bien qu'il s'agisse d'un processus très gourmand en ressources qui exige une puissance de calcul et des ensembles de données massifs, il donne aux organisations un contrôle total sur l'architecture du modèle, les données d'entraînement et le processus d'optimisation. En outre, l'organisation conserve l'intégralité des droits de propriété intellectuelle sur les modèles obtenus.
La formation de modèles peut déboucher sur des applications avancées telles que la découverte de médicaments, la science des matériaux ou les systèmes autonomes. Une organisation de soins de santé pourrait développer un modèle pour aider à diagnostiquer des maladies à partir de dossiers médicaux et de données d'imagerie, par exemple.
Implications en matière de sécurité liées à la formation au modèle
La formation de LLM personnalisés soulève des questions difficiles sur la manière de maintenir la responsabilité et l'auditabilité du comportement du modèle lorsqu'il s'agit de modèles complexes à boîte noire. Le processus de formation lui-même consomme d'énormes ressources informatiques, ce qui nécessite une forte isolation et des contrôles d'accès autour de l'environnement de formation afin d'éviter les abus ou les interférences. Tout d'abord, l'organisation doit mettre en place une infrastructure de calcul à haute performance et conserver soigneusement des ensembles de données massives, ce qui peut poser de nouveaux défis en matière de sécurité.
LLM Préoccupations en matière de sécurité
L'une des principales préoccupations liées au déploiement de modèles linguistiques de grande taille dans les entreprises est la possibilité d'inclure des données sensibles lors de la formation. Une fois que les données ont été incorporées dans ces modèles, il devient difficile de discerner précisément les informations qui les ont alimentés. Ce manque de visibilité peut s'avérer problématique si l'on considère la myriade de sources de données utilisées pour la formation et les différentes personnes qui peuvent accéder à ces données.
Garantir la visibilité des sources de données et maintenir un contrôle strict sur les personnes qui y ont accès est crucial pour éviter l'exposition involontaire d'informations confidentielles.
Le risque d'utilisation abusive des LLM dans le cadre de cyberattaques constitue un autre sujet de préoccupation. Les acteurs malveillants peuvent utiliser les LLM pour concevoir des courriels de hameçonnage persuasifs afin de tromper les individus et d'obtenir un accès non autorisé à des données sensibles. Cette méthode, connue sous le nom d'ingénierie sociale, permet de créer des contenus convaincants et trompeurs, ce qui accroît les difficultés liées à la protection des données.
En l'absence de contrôles d'accès et de protections rigoureux, le risque d'importantes violations de données augmente, et les acteurs malveillants acquièrent la capacité de diffuser facilement des informations erronées, de la propagande ou d'autres contenus préjudiciables.
Si les LLM ont des applications positives quasi infinies, ils recèlent le potentiel de créer des codes malveillants, en contournant les filtres conventionnels destinés à empêcher de tels comportements. Cette vulnérabilité pourrait conduire à une nouvelle ère de cybermenaces où les fuites de données ne se limitent pas au vol d'informations, mais génèrent des contenus et des codes dangereux.
S'ils sont manipulés, par exemple, les LLM peuvent produire des logiciels, des scripts ou des outils malveillants susceptibles de mettre en péril des systèmes entiers. Leur potentiel de "reward hacking" suscite des inquiétudes dans le domaine de la cybersécurité, suggérant que des méthodes involontaires pour atteindre leurs objectifs pourraient être découvertes, conduisant à un accès accidentel ou à la récolte de données sensibles.
Alors que nous dépendons de plus en plus des applications LLM, il devient impératif pour les organisations et les individus de rester vigilants face à ces menaces émergentes, préparés à protéger les données à tout moment.
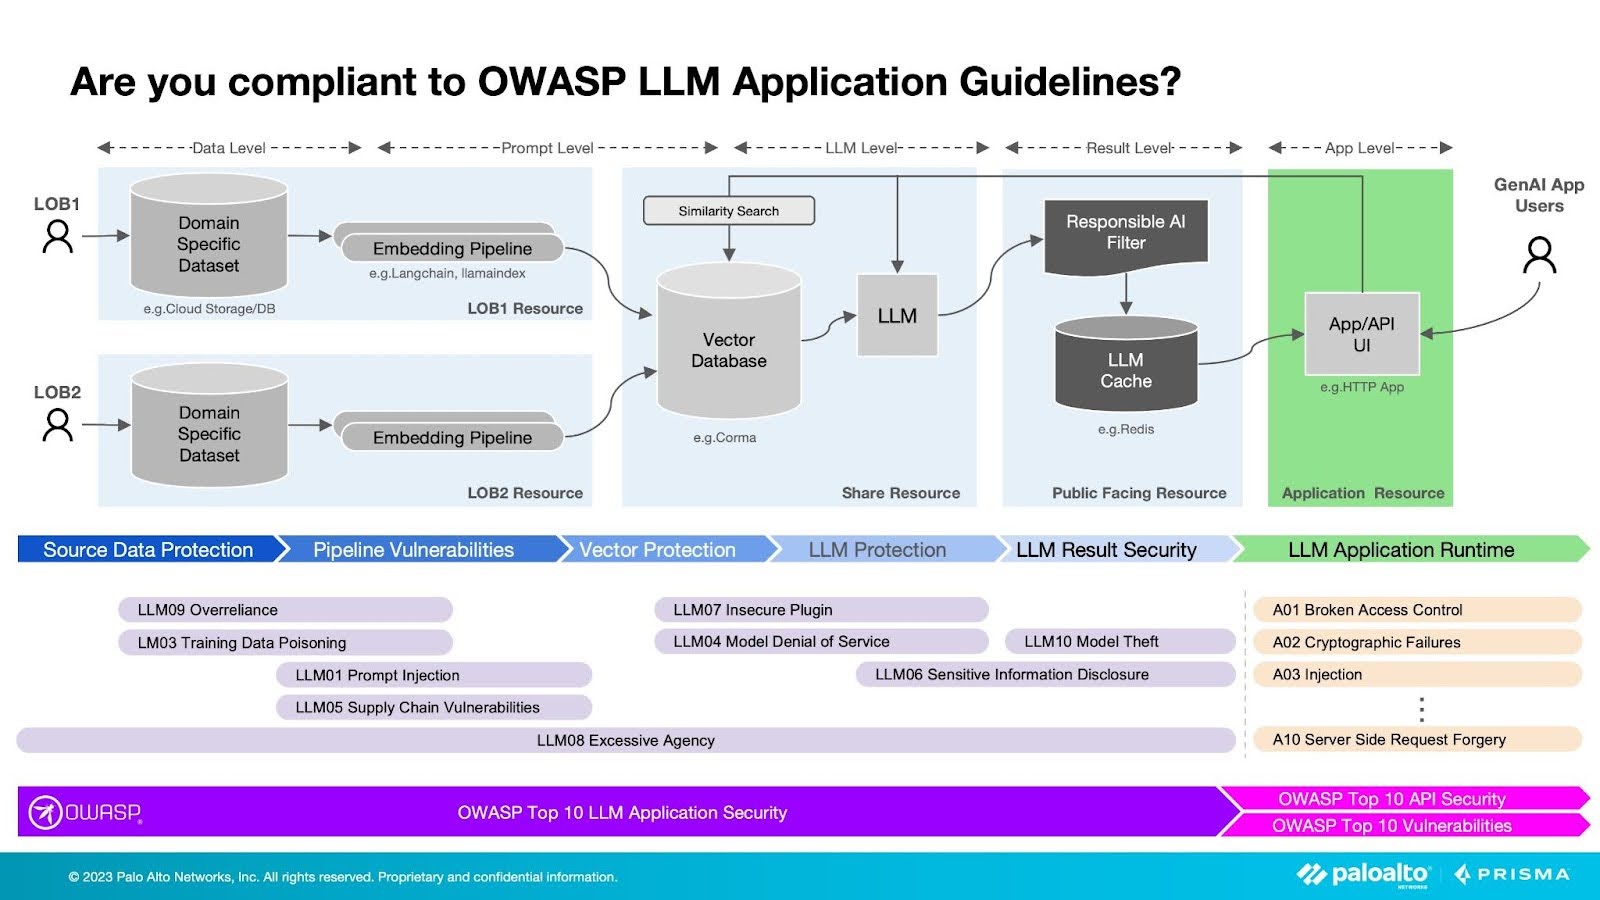
Figure 1 : Protéger les LLM des principaux risques de sécurité de l'OWASP
Le Top 10 de l'OWASP : Risques liés à la sécurité du LLM
Les vulnérabilités des applications conventionnelles présentent une nouvelle série de risques de sécurité au sein des LLM. Mais fidèle à ses habitudes, l'OWASP a livré le OWASP Top Ten LLM Security Risks en temps opportun, alertant les développeurs sur les nouveaux mécanismes et la nécessité d'adapter les stratégies de remédiation traditionnelles pour leurs applications utilisant des LLM.
LLM01 : Injection rapide
L'injection d'invites peut manipuler un grand modèle de langage par le biais d'entrées détournées, amenant le LLM à exécuter les intentions de l'attaquant. Avec les injections directes, l'acteur malveillant écrase les invites du système. Avec les injections indirectes, les attaquants manipulent des entrées provenant de sources externes. L'une ou l'autre méthode peut entraîner une exfiltration de données, de l'ingénierie sociale et d'autres problèmes.
LLM02 : Traitement non sécurisé des sorties
Le traitement non sécurisé des sorties est une vulnérabilité qui se produit lorsqu'une sortie LLM est acceptée sans examen, exposant ainsi les systèmes dorsaux. Elle survient lorsqu'un composant en aval accepte aveuglément les résultats du LLM sans examen approfondi. Une utilisation abusive peut entraîner des scripts intersites (XSS) et des falsifications de requêtes intersites (CSRF) dans les navigateurs web, ainsi que des falsifications de requêtes côté serveur (SSRF), une élévation des privilèges et l'exécution de codes à distance sur les systèmes dorsaux.
LLM03 : Empoisonnement des données de formation
L'empoisonnement des données de formation se produit lorsque les données de formation LLM sont manipulées via Common Crawl, WebText, OpenWebText, des livres et d'autres sources. La manipulation introduit des portes dérobées, des vulnérabilités ou des biais qui compromettent la sécurité du LLM et entraînent une baisse des performances, l'exploitation de logiciels en aval et une atteinte à la réputation.
LLM04 : Modèle de déni de service
On parle de déni de service lorsqu'un attaquant exploite un LLM pour déclencher une opération gourmande en ressources, ce qui entraîne une dégradation du service et une augmentation des coûts. Cette vulnérabilité est amplifiée par la nature exigeante des LLM et la nature imprévisible des données fournies par les utilisateurs. Dans un scénario de déni de service, un attaquant s'engage avec un LLM d'une manière qui demande une quantité disproportionnée de ressources, entraînant une baisse de la qualité du service pour l'attaquant et les autres utilisateurs tout en générant potentiellement d'importantes dépenses en ressources.
LLM05 : Vulnérabilités de la chaîne d'approvisionnement
Les vulnérabilités de la chaîne d'approvisionnement des ML peuvent compromettre les données d'entraînement, les modèles ML et les plateformes de déploiement, provoquant des failles de sécurité ou des défaillances totales du système. Les composants ou services vulnérables peuvent provenir de données d'entraînement empoisonnées, de plugins non sécurisés, de logiciels obsolètes ou de modèles pré-entraînés sensibles.
LLM06 : Divulgation d'informations sensibles
Les applications LLM peuvent exposer des données sensibles, des informations confidentielles et des algorithmes propriétaires, ce qui entraîne des accès non autorisés, des vols de propriété intellectuelle et des violations de données. Pour atténuer ces risques, les applications LLM doivent assainir les données, mettre en œuvre des politiques d'utilisation strictes et appropriées et restreindre les types de données renvoyées par le LLM.
LLM07 : Conception de plugins non sécurisés
Les plugins peuvent comprendre des entrées non sécurisées et un contrôle d'accèsinsuffisant, ce qui les rend sujets à des requêtes malveillantes pouvant conduire à une exfiltration de données, à une exécution de code à distance et à une élévation de privilèges. Les développeurs doivent respecter des règles strictes en matière d'entrées paramétrées et de contrôle d'accès sécurisé afin d'éviter toute exploitation.
LLM08 : Agence excessive
L'agence excessive se réfère aux systèmes basés sur le LLM qui prennent des mesures entraînant des conséquences non intentionnelles. La vulnérabilité découle de l'octroi d'une trop grande autonomie, d'une sur-fonctionnalité ou de permissions excessives au mécanisme d'apprentissage tout au long de la vie. Les développeurs doivent limiter les fonctionnalités des plugins à ce qui est absolument essentiel. Ils doivent également assurer le suivi des autorisations des utilisateurs, exiger une approbation humaine pour toutes les actions et mettre en œuvre les autorisations dans les systèmes en aval.
LLM09 : Dépendance excessive
Un LLM peut générer un contenu inapproprié lorsque des utilisateurs humains ou des systèmes s'appuient de manière excessive sur le LLM sans assurer une surveillance adéquate. Les conséquences potentielles du LLM09 sont la désinformation, les failles de sécurité et les problèmes juridiques.
LLM10 : Modèle Vol
Le vol de modèle LLM implique l'accès non autorisé, la copie ou l'exfiltration de LLM propriétaires. Le vol de modèles entraîne des pertes financières et une perte d'avantage concurrentiel, ainsi qu'une atteinte à la réputation et un accès non autorisé à des données sensibles. Les organisations doivent appliquer des mesures de sécurité strictes pour protéger leurs MLD propriétaires.
FAQ sur les grands modèles linguistiques
Pour protéger votre LLM, mettez en œuvre une approche de sécurité à multiples facettes qui comprend des contrôles d'accès stricts, une restriction de l'accès aux ressources du réseau via la segmentation du réseau et le sandboxing sécurisé, une surveillance constante des ressources et des audits de routine des journaux et des activités associées au LLM.
La structure du modèle LLM est basée sur l'architecture du transformateur, qui traite et génère des séquences de données à l'aide de mécanismes d'auto-attention.
La phase initiale de la construction d'un grand modèle linguistique consiste à rassembler une grande quantité de données textuelles pour la formation, qui sont segmentées en unités de données plus petites, appelées tokens, afin de faciliter le traitement et l'apprentissage.
La PNL est un sous-domaine de l'IA et de la linguistique qui vise à permettre aux ordinateurs de comprendre, d'interpréter et de générer du langage humain. Le NLP englobe un large éventail de tâches, notamment l'analyse des sentiments, la traduction automatique, le résumé de texte et la reconnaissance des entités nommées. Les techniques NLP font généralement appel à des algorithmes informatiques, à la modélisation statistique et à l'apprentissage automatique pour traiter et analyser les données textuelles.
Un LLM est un type de modèle de Deep Learning, plus précisément un réseau neuronal, conçu pour traiter les tâches de NLP à grande échelle. Les LLM, tels que GPT-3 et BERT, sont formés sur de grandes quantités de données textuelles afin d'apprendre des modèles de langage, une grammaire et une sémantique complexes. Ces modèles s'appuient sur une technique appelée architecture de transformation, qui leur permet de saisir les dépendances à long terme et les informations contextuelles dans le langage.
La principale différence entre le NLP et le LLM est que le NLP est un domaine plus large qui englobe diverses techniques et approches de traitement du langage humain, tandis que le LLM est un type spécifique de modèle de réseau neuronal conçu pour des tâches NLP avancées. Les LLM représentent une approche de pointe dans le domaine du NLP, offrant des performances et des capacités améliorées dans la compréhension et la génération d'un langage de type humain par rapport aux méthodes NLP traditionnelles.
Dans le domaine de l'apprentissage automatique, un modèle de formation fait référence au processus de développement d'une représentation mathématique capable de faire des prédictions ou de prendre des décisions sur la base de données d'entrée. En alimentant un modèle avec des données d'apprentissage étiquetées, il apprend à reconnaître des modèles, des relations et des caractéristiques qui lui permettent de généraliser et de faire des déductions précises sur des données inédites. Le processus d'apprentissage consiste à ajuster les paramètres du modèle de manière itérative afin de minimiser les erreurs et d'améliorer les performances. Une fois que le modèle atteint une précision et des capacités de généralisation satisfaisantes, il peut être déployé pour résoudre des problèmes du monde réel, tels que la reconnaissance d'images, le traitement du langage naturel ou la prédiction du comportement des clients.
L'intelligence artificielle (IA) est une branche de l'informatique qui se concentre sur la création de systèmes intelligents capables de simuler les capacités cognitives humaines, telles que la résolution de problèmes, la reconnaissance de formes et la prise de décision. En tirant parti des algorithmes, des données et de la puissance de calcul, les systèmes d'IA peuvent tirer des enseignements de l'expérience, s'adapter à de nouvelles informations et exécuter des exigences qui requièrent généralement l'intelligence humaine. Ces systèmes ont des applications dans divers secteurs, notamment la santé, la finance et la fabrication, permettant l'automatisation, l'amélioration de la productivité et la mise en place de solutions innovantes.
L'apprentissage automatique est un sous-domaine de l'intelligence artificielle qui consiste à développer des algorithmes permettant aux ordinateurs d'apprendre et d'améliorer leurs performances dans des tâches spécifiques sans programmation explicite. En traitant et en analysant de grands ensembles de données, les modèles de ML peuvent identifier des modèles, faire des prédictions et générer des idées, devenant de plus en plus précis et efficaces au fur et à mesure qu'ils reçoivent plus de données. Les techniques de ML, telles que l'apprentissage supervisé, non supervisé et par renforcement, ont de nombreuses applications, notamment le traitement du langage naturel, la reconnaissance d'images et les systèmes de recommandation.
L'IA générative est un sous-ensemble de l'intelligence artificielle qui se concentre sur la création de nouveaux contenus, données ou modèles en apprenant à partir d'exemples existants. Cette forme d'IA s'appuie sur des techniques avancées d'apprentissage automatique, telles que les réseaux adversaires génératifs (GAN) et les autoencodeurs variationnels (VAE), pour générer des sorties inédites qui ressemblent aux données d'entrée. Les applications de l'IA générative comprennent la synthèse d'images, la génération de texte et l'augmentation des données, permettant des solutions innovantes dans des domaines tels que l'art, le design, le divertissement et la science des données.
Les réseaux adversaires génératifs (GAN) sont une classe de modèles d'apprentissage automatique conçus pour générer de nouveaux échantillons de données qui ressemblent à un ensemble de données donné. Les GAN sont constitués de deux réseaux neuronaux, un générateur et un discriminateur, qui sont formés simultanément de manière compétitive. Le générateur crée des échantillons synthétiques, tandis que le discriminateur évalue les échantillons générés et les distingue des données réelles.
Le générateur améliore constamment ses capacités de production de données en tentant de tromper le discriminateur qui, à son tour, affine sa capacité à identifier les échantillons réels par rapport aux échantillons générés. Ce processus contradictoire se poursuit jusqu'à ce que les échantillons générés deviennent presque indiscernables des données réelles, ce qui rend les GAN particulièrement utiles dans des applications telles que la synthèse d'images, l'augmentation des données et le transfert de style.
Les autoencodeurs variationnels (VAE) sont un type de modèle génératif qui apprend à représenter des distributions de données complexes en encodant les données d'entrée dans un espace latent de dimension inférieure, puis en reconstruisant les données à partir de cette représentation comprimée. Les VAE se composent de deux réseaux neuronaux : un encodeur qui fait correspondre les données d'entrée à une distribution de probabilités dans l'espace latent, et un décodeur qui reconstruit les données à partir de points échantillonnés dans cette distribution.
Le modèle VAE est entraîné pour minimiser l'erreur de reconstruction et un terme de régularisation qui encourage la distribution apprise à s'aligner sur une distribution préalable prédéfinie. Les VAE sont capables de générer de nouveaux échantillons de données en décodant des points aléatoires échantillonnés dans l'espace latent, ce qui les rend adaptés à des applications telles que la génération d'images, le débruitage de données et l'apprentissage de représentations.


